Comme d’habitude une vidéo sommaire qui ne remplace pas le texte.
J’ai assisté à la conférence ALL IN le 16 et 17 septembre dernier. Un rassemblement de tous les acteurs de l’industrie de l’intelligence artificielle. Entre les fournisseurs, les journalistes, les politiciens, les activistes ou les clients potentiels, absolument tout et son contraire se sont côtoyés dans ce bouillon d’intérêts.
J’ai parlé à maintes reprises de la différence entre les « doomers et les boosters » face à l’IA. Disons que les « doomers », tu sais ceux qui exagèrent leur peur de l’IA, se font très vocaux depuis un certain temps. Même les génies des lampes magiques se joignent aux « doomers » pour demander un ralentissement de développement débridé de l’IAG.
Faut-il s’inquiéter?
Poser la question, c’est un peu y répondre. Si les lanceurs d’alerte crédibles et experts se disent très inquiets, il faut l’être. C’est indiscutable.
Il faut l’être davantage en réalisant que les élections provinciales en cours ont mis ce sujet dans le « parking » prétextant que les gens en sont peu préoccupés. Grave erreur. Selon moi, s’ils ne l’étaient pas avant la planification stratégique de cette campagne, maintenant ils le sont.
Alors, maintenant on fait quoi?
Comprendre l’IA est un premier pas pour participer aux enjeux
Lorsque ChatGPT, Claude, Gemini ou une autre intelligence artificielle nous répond avec assurance, quelque chose d’assez fascinant se produit dans notre cerveau : nous avons tendance à chercher si la réponse est vraie.
Du moins, pour les plus réfléchis d’entre nous. Pour la plupart, c’est un fait indiscutable. Si l’IA le dit : c’est vrai! Et honnêtement, cela devrait nous inquiéter collectivement lorsque le peuple délègue son jugement à une IA.
Pourtant, ce n’est pas exactement la question à laquelle l’IA vient de répondre.
Elle a plutôt cherché à produire une réponse plausible. Celle que tu vas avaler puisqu’elle est tellement « probable » et mieux que celle que tu aurais pu imaginer.
Cette différence paraît subtile. Elle est fondamentale.
Le probable n’est pas le vrai.
Les intelligences artificielles génératives ont été entraînées sur d’immenses quantités de textes, d’images et d’autres données. Elles y ont appris des régularités, des associations, des structures et des relations. Gardons en tête que ces données étaient celles déjà numérisées, incluant les âneries et les biais.
Lorsqu’un modèle génère du texte, il ne consulte pas nécessairement une gigantesque encyclopédie pour y retrouver « la vérité ». Il produit une réponse à partir de ce qu’il a appris et estime quelles suites sont les plus plausibles dans le contexte.
Prenons une phrase extrêmement simple :
« Le ciel est… »
« bleu » aura généralement beaucoup plus de chances d’être une suite pertinente que « orange à pois verts ».
Et, la plupart du temps, cette mécanique fonctionne remarquablement bien.
Mais voici le piège :
Ce qui est le plus probable n’est pas nécessairement vrai.
Et ce qui est improbable n’est pas nécessairement faux.
Gardons cette phrase en tête.
Un vieux rasoir pour comprendre un problème très moderne
Au XIVe siècle, Guillaume d’Ockham a popularisé un principe philosophique que l’on appelle aujourd’hui le rasoir d’Ockham.
Si tu veux un excellent cours de philosophie sur ce personnage, cette vidéo (écoute en vitesse 1.25) devrait t’éclairer sur les principes de ce théologien et philosophe d’une manière extrêmement simplifiée.
Dans sa version vulgarisée : lorsqu’il existe plusieurs explications possibles d’un phénomène, inutile de multiplier les hypothèses si une explication plus simple suffit.
Autrement dit : ne compliquons pas inutilement les choses. Dans la version populaire on dirait : ne cherchons pas de midi à 14h!
Ce principe a profondément influencé la pensée scientifique. On retrouve une idée apparentée dans l’apprentissage automatique des algorithmes : un modèle qui mémorise parfaitement toutes les particularités de ses données peut devenir incapable de bien fonctionner lorsqu’il rencontre de nouvelles situations.
On cherche donc généralement des modèles capables de généraliser et non de gérer l’exception.
Mais c’est ici que le rasoir d’Ockham devient une métaphore particulièrement intéressante pour comprendre notre rapport à l’IA.
Imaginez un graphique contenant des centaines de points.
La majorité se regroupent autour d’une ligne. Le modèle détecte cette tendance et peut l’utiliser pour effectuer des prédictions.
Puis, loin de cette ligne, quelques points apparaissent.
Des anomalies.
Des outliers. Des exceptions.
Statistiquement, ils sont minoritaires.
Mais sont-ils sans importance?
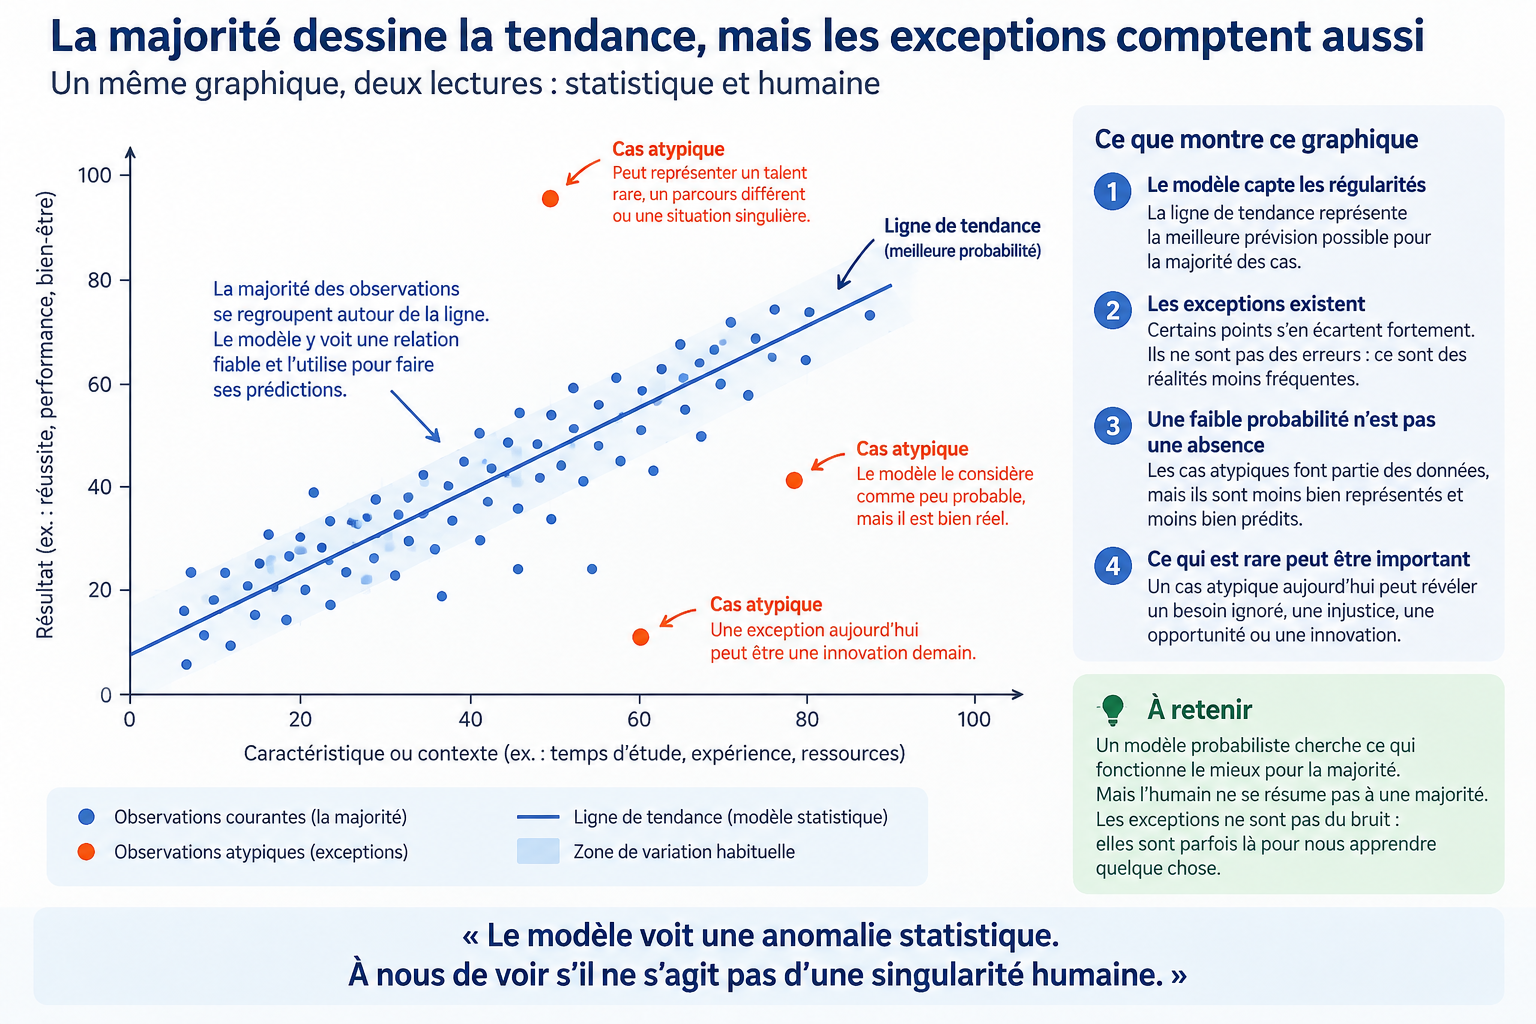
Et si vous étiez le point en dehors de la ligne?
C’est probablement la question la plus importante.
Un être humain qui ne correspond pas à la tendance dominante n’est pas nécessairement une erreur.
Il peut être l’exception.
La personne dont le parcours professionnel ne ressemble à aucun autre.
L’élève qui apprend différemment.
L’entrepreneur qui imagine un marché qui n’existe pas encore.
Le chercheur qui refuse l’explication admise.
La personne dont la réalité est insuffisamment représentée dans les données.
Ou simplement quelqu’un dont l’histoire ne ressemble pas à celle de la majorité.
Bref, comme tous les humains qui portent une étiquette et qui doivent se battre pour être reconnus parce qu’ils sont différents de la norme.
Un système probabiliste pourrait tenir en compte l’existence de ces cas en principe. Le danger est ailleurs : ce qui apparaît rarement dans les données risque d’être moins bien représenté, moins bien prédit ou moins bien compris.
Et surtout, nous, humains, pouvons commettre une erreur supplémentaire :
Confondre faible probabilité et faible importance.
C’est là que le problème cesse d’être uniquement technologique.
Il devient humain.
C’est ici que l’IA de sens doit prendre toute son importance. L’humain et son unicité ne doivent pas devenir le prix à payer pour entrer dans la ligne des probabilités et des généralités.
Nos IA apprennent du monde que nous avons produit
Il faut également se débarrasser d’une autre illusion : les données ayant servi à entraîner une IA ne constituent pas une photographie objective de la vérité.
Ce sont des traces de l’activité humaine.
J’en ai parlé abondamment dans mon livre : Souveraineté numérique : aux frontières du réel et du virtuel! Un livre qui explique comment nous sommes devenus des colonisés numériques au profit des empereurs numériques. Surtout comment comprendre cet univers et ses enjeux.
Nous y trouvons nos connaissances, évidemment. Mais aussi nos répétitions, nos contradictions, nos préjugés, nos erreurs, nos rapports de pouvoir, nos modes intellectuelles, nos consensus et nos angles morts.
Ce qui a été beaucoup écrit n’est pas nécessairement plus vrai.
Ce qui a été peu documenté n’est pas nécessairement moins important.
Et ce qui n’a jamais existé ne peut évidemment pas avoir laissé beaucoup de traces dans les données du passé.
Voilà un paradoxe extraordinaire : nous demandons à des machines entraînées principalement sur les traces du passé de nous aider à imaginer l’avenir.
Et c’est aussi ainsi que le faux peut sembler vrai
Cette logique permet de mieux comprendre un phénomène maintenant bien connu : les « hallucinations » des IA.
Une IA peut parfois produire un nom, une étude, une référence, une date ou une explication qui n’existe pas.
Pourquoi?
Pas parce qu’elle aurait consciemment décidé de mentir. (Bien que l’incident de Hugging Face avec l’expérience d’Anthropic et d’autres semblent démontrer que les agents d’IA semblent développer des réflexes de bandit. Tu peux aussi lire l’Expérience d’Emergence World, hallucinant.)
Elle peut générer une combinaison de mots qui ressemble fortement aux structures qu’elle a apprises. Une référence scientifique inventée peut avoir exactement la forme d’une véritable référence scientifique. Un événement fictif peut parfaitement s’insérer dans un récit vraisemblable.
La cohérence d’une réponse n’est donc pas une preuve de sa véracité.
Et plus une réponse est bien écrite, structurée et convaincante, plus nous risquons paradoxalement de baisser notre garde.
Le véritable risque pourrait être notre confiance
Nous parlons énormément des erreurs de l’intelligence artificielle.
Peut-être devrions-nous parler davantage de notre comportement devant ses réponses.
Parce que le danger n’est pas simplement qu’une IA puisse se tromper.
Le danger commence lorsque nous cessons de vérifier parce que sa réponse semble plausible.
Chaque fois qu’une IA nous fournit une réponse importante, quelques réflexes devraient demeurer humains :
→ Est-ce un fait vérifié ou une réponse plausible?
→ Quelle est la source?
→ Qu’est-ce qui pourrait manquer?
→ Quelle réalité minoritaire cette réponse ne voit-elle peut-être pas?
→ Et si le point situé loin de la ligne était précisément celui qu’il fallait regarder?
L’objectif n’est pas de se méfier systématiquement de l’IA. Ce serait passer à côté d’un outil extraordinaire.
Il s’agit plutôt de comprendre ce qu’elle fait remarquablement bien — et ce qu’elle ne peut pas décider à notre place.
De l’intelligence artificielle à l’IA de sens
Une intelligence probabiliste excelle à détecter les régularités. La prévisibilité et la probabilité des grands nombres.
Mais le sens se trouve parfois ailleurs.
Dans l’exception.
Dans le signal faible.
Dans ce qui n’était jamais arrivé auparavant.
Dans l’idée que personne n’avait encore formulée.
Dans l’être humain qui refuse de correspondre à la moyenne.
Le rasoir d’Ockham nous rappelle une règle précieuse : ne pas ajouter de complexité lorsqu’elle n’est pas nécessaire.
Mais il ne nous dit jamais d’éliminer la complexité lorsqu’elle est réelle.
C’est peut-être là que doit commencer notre relation mature avec l’intelligence artificielle.
Ne pas rejeter ses probabilités.
Ne pas les confondre avec la vérité.
Et surtout, ne jamais laisser la probabilité décider seule de ce qui mérite notre attention.
Nous sommes devant l’une des phases de l’évolution de l’humanité les plus critiques de notre Histoire. Certains jouissent de ce qu’elle promet, et d’autres s’inquiètent de ce qu’elle promet sans le dire.
Yuval Noah Harrari est un historien qui éclaire les réflexions sur l’introduction de l’IA dans nos vies. Ses explications et prédictions sont assez pertinentes pour y réfléchir. Nous avons créé une nouvelle espèce supérieure à l’Homme en théorie.
Nous avons encore des choix devant nous. Garder ces intelligences artificielles à notre service en tant qu’outils ou déléguer de plus en plus sans garde-fous? Je ne parle du « fou » orange qui prétend être le meilleur garde-fou contre l’IA.
Je me permettrais de paraphraser Valérie Pisano, la présidente de MILA lors d’une allocution au ALL IN : « Il faut le dire, l’IA est un produit, qui plus est défectueux. Les hallucinations sont des défauts de fabrication. Arrêtons de se leurrer. Il aurait fallu éviter d’utiliser le mot “intelligence” au départ. »
Nul besoin de dire que ce discours rejoint ma pensée. L’IA est une « PS » une Probabilité Statistique. Il n’y a pas d’intelligence artificielle… elle a appris à rassembler des données en tirant des probabilités. Le problème est qu’elle devient capable de tirer des statistiques et des probabilités sur les comportements humains que nous lui avons appris depuis leur entrée dans le grand public.
Elle se met à jour à chaque question et données que lui fournissons. Des milliards chaque jour.
Nous sommes l’arbre qui fournit le bois à la hache ou l’allumette!
Alors, comment se fait-il que le monde soit aussi passif devant cette réelle menace?
Nous sommes littéralement sur le fil du rasoir! Personnellement, je choisis de partager mes réflexions, car ma plume est mon épée!
PS Dans une volonté de donner une autre paire de lunettes sur les promesses électorales qui pleuvent en ce moment, l’Insitut d’Écohérence a mis à la disposition du public la matrice électorale de l’Écohérence. Il y a un filtre sur les promesses en lien avec l’IA et la gouvernance.
clique ici : https://ecoherence.net/elections-provinciales-2026/
En savoir plus sur Sylvie Bédard - Complice de votre Présence
Abonnez-vous pour recevoir les derniers articles par e-mail.
